 شاهین آقامعلی
دادههای مصنوعی به یکی از فناوریهای مهم در توسعه سیستمهای هوش مصنوعی تبدیل شدهاند؛ فناوریای که میتواند هزینه جمعآوری داده، زمان آمادهسازی مدلها و محدودیتهای دسترسی به اطلاعات حساس را کاهش دهد. با افزایش نیاز مدلهای یادگیری ماشین به دادههای متنوع و باکیفیت، پژوهشگران و شرکتهای فناوری به روشهایی روی آوردهاند که بهجای اتکا به دادههای جمعآوریشده از دنیای واقعی، نمونههای جدید و مصنوعی تولید میکنند. بااینحال، داده مصنوعی صرفاً دادهای ساختگی نیست؛ ارزش آن به میزان شباهت آماری به واقعیت، کیفیت اطلاعات تولیدشده و توانایی آن در بهبود عملکرد مدل بستگی دارد. در این مقاله بررسی میکنیم که داده مصنوعی چیست، چگونه تولید میشود، چه کاربردهایی دارد و چرا استفاده نادرست از آن میتواند به نتایج گمراهکننده منجر شود.
دادههای مصنوعی (Synthetic Data) چیست؟
داده مصنوعی به اطلاعاتی گفته میشود که بهجای اندازهگیری یا مشاهده مستقیم پدیدههای واقعی، با استفاده از الگوریتمهای آماری، شبیهسازی یا مدلهای هوش مصنوعی و یادگیری ماشین تولید میشوند. هدف این است که دادههای تولیدشده، ویژگیها، روابط و الگوهای مهم مجموعهداده واقعی را تا حد مناسبی بازتاب دهند، بدون آنکه الزاماً شامل همان مشاهدات واقعی باشند. این دادهها میتوانند به شکل جدولهای عددی، تصاویر، متن، ویدئو، دادههای حسگر یا سوابق شبیهسازیشده ظاهر شوند.
برای مثال، فرض کنید میخواهیم مدلی برای پیشبینی ریزش مشتریان یک فروشگاه اینترنتی بسازیم. دسترسی به اطلاعات واقعی مشتریان ممکن است به دلیل مسائل محرمانگی محدود باشد یا تعداد نمونههای مربوط به مشتریان ازدسترفته کافی نباشد. در چنین شرایطی میتوان مجموعهای مصنوعی تولید کرد که ویژگیهایی مانند مدت عضویت، تعداد خرید، میانگین مبلغ سفارش و احتمال ترک سرویس را در بر بگیرد. اگر این دادهها روابط آماری معقولی داشته باشند، میتوانند به آموزش اولیه یا آزمایش مدل کمک کنند؛ البته عملکرد نهایی مدل باید همچنان با دادههای واقعی و مستقل ارزیابی شود. نکته مهم این است که مصنوعی بودن داده بهتنهایی به معنای دقیق، بیطرف یا کاملاً محرمانه بودن آن نیست. کیفیت داده به روش تولید و اعتبارسنجی آن بستگی دارد و حتی دادهای که بهصورت مصنوعی تولید شده است، ممکن است اطلاعات حساس را بازتاب دهد.
دادههای مصنوعی چگونه تولید میشوند؟
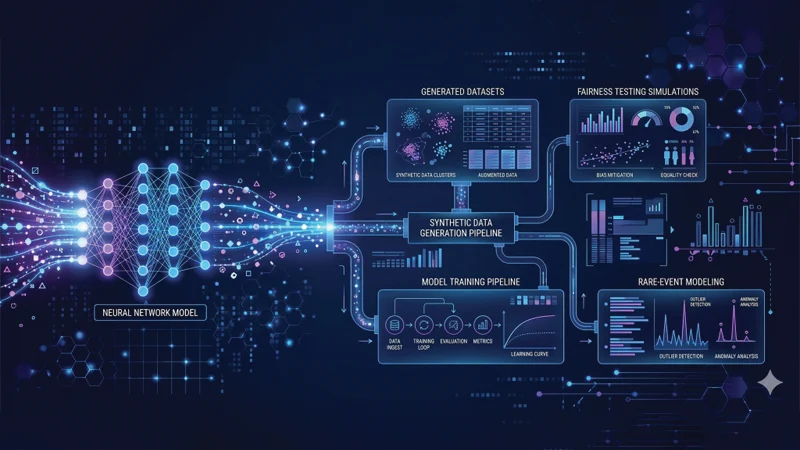
روش تولید داده مصنوعی با توجه به نوع مسئله، ساختار داده و میزان دقت موردنیاز انتخاب میشود. برخی روشها برای جدولهای عددی و دادههای تجاری مناسباند، درحالیکه روشهای پیشرفتهتر برای تولید تصویر، متن یا شبیهسازی محیطهای پیچیده به کار میروند.
۱. روشهای آماری و احتمالاتی
در روشهای آماری، ابتدا توزیع ویژگیها و روابط میان متغیرهای داده واقعی بررسی میشود. سپس نمونههای جدید از توزیعهای احتمالاتی یا مدلهای آماری برازششده تولید میشوند. برای مثال، میتوان دادههایی با توزیع مشخص برای سن مشتریان یا مبلغ سفارشها ساخت؛ اما اگر روابط میان ویژگیها پیچیده باشد، تولید مستقل هر ستون ممکن است دادههایی غیرواقعی ایجاد کند. به همین دلیل، حفظ همبستگیها و وابستگیهای میان متغیرها اهمیت زیادی دارد.
۲. مدلهای مولد یادگیری ماشین
در این روش، یک مدل از ساختار دادههای موجود یاد میگیرد و سپس نمونههای جدیدی با الگوهای مشابه تولید میکند. شبکههای مولد تخاصمی (GAN)، خودرمزگذارهای واریاسیونی (VAE) و برخی مدلهای مولد جدید از فناوریهای مورد استفاده در این حوزه هستند. برای نمونه، GAN میتواند با یادگیری ویژگیهای تصاویر واقعی، تصاویر مصنوعی تولید کند که برای آموزش سیستمهای تشخیص تصویر یا آزمایش الگوریتمهای بینایی ماشین مفید باشند. بااینحال، خروجی این مدلها به کیفیت داده آموزشی و توانایی مدل در بازنمایی تنوع واقعی وابسته است.
۳. شبیهسازی و تولید داده در محیطهای مجازی
گاهی بهجای یادگیری مستقیم از دادههای موجود، یک محیط شبیهسازیشده ساخته میشود تا بتوان سناریوهای مختلف را در آن اجرا کرد. این روش در رباتیک، خودروهای خودران و سیستمهای صنعتی اهمیت دارد؛ زیرا جمعآوری نمونههای واقعی از تصادف، خرابی تجهیزات یا شرایط خطرناک میتواند پرهزینه و دشوار باشد. شبیهساز میتواند شرایطی مانند نور کم، بارندگی، موانع غیرمنتظره یا اختلال در عملکرد حسگرها را ایجاد کند تا مدل پیش از مواجهه با این شرایط در دنیای واقعی آموزش ببیند.
مزایای داده مصنوعی در آموزش مدلهای یادگیری ماشین
استفاده از دادههای مصنوعی میتواند بخش مهمی از مشکلات توسعه مدلهای یادگیری ماشین و یادگیری عمیق را برطرف کند؛ بهویژه زمانی که دادههای واقعی کمیاب، گرانقیمت، نامتوازن یا محرمانه هستند. بااینحال، این مزایا زمانی محقق میشوند که داده تولیدشده کیفیت مناسبی داشته باشد و با هدف مدل هماهنگ باشد.
کاهش هزینه و افزایش سرعت توسعه مدل
جمعآوری داده واقعی، پاکسازی آن و برچسبگذاری نمونهها ممکن است زمان و منابع زیادی نیاز داشته باشد. داده مصنوعی این امکان را فراهم میکند که تعداد زیادی نمونه در زمان کوتاه تولید شوند و در بسیاری از موارد، برچسب هر نمونه نیز هنگام تولید مشخص باشد. برای مثال، در یک پروژه طبقهبندی تصاویر میتوان نمونههایی با اشیا و شرایط نوری متفاوت ساخت تا نیاز به ثبت و برچسبگذاری دستی همه تصاویر کاهش یابد. البته تولید داده بهتنهایی کافی نیست؛ کنترل کیفیت و ارزیابی آن همچنان ضروری است.
بهبود دادههای نامتوازن و نمونههای نادر
یکی از مشکلات رایج در یادگیری ماشین، نامتوازن بودن کلاسهاست. برای مثال، در یک سامانه تشخیص تقلب مالی ممکن است تعداد تراکنشهای سالم بسیار بیشتر از تراکنشهای متقلبانه باشد. در این وضعیت، مدل ممکن است به پیشبینی کلاس غالب تمایل پیدا کند و موارد تقلب را بهخوبی تشخیص ندهد. داده مصنوعی میتواند برای تولید نمونههای بیشتر از کلاس اقلیت استفاده شود. بااینحال، اگر نمونههای تولیدشده بیش از حد ساده یا غیرواقعی باشند، ممکن است مدل به الگوهای اشتباه وابسته شود.
افزایش محرمانگی و کاهش محدودیت دسترسی به داده
در حوزههایی مانند پزشکی، بانکداری و بیمه، دسترسی به داده واقعی به دلیل حساسیت اطلاعات و الزامات قانونی محدود است. داده مصنوعی میتواند امکان آزمایش و توسعه مدل را بدون انتشار مستقیم بسیاری از سوابق واقعی فراهم کند. بااینحال، داده مصنوعی لزوماً ناشناس یا کاملاً امن نیست؛ بعضی روشهای تولید ممکن است اطلاعات خاص افراد را بازتولید کنند یا امکان استنباط اطلاعات حساس را باقی بگذارند. بنابراین، ارزیابی خطر افشای اطلاعات و استفاده از روشهایی مانند حریم خصوصی تفاضلی (Differential Privacy) در موارد لازم اهمیت دارد.
کاربردهای داده مصنوعی در صنایع مختلف
دادههای مصنوعی محدود به یک حوزه خاص نیستند. از توسعه مدلهای بینایی ماشین گرفته تا آزمایش نرمافزار و پیشبینی رویدادهای صنعتی، این فناوری میتواند در مراحل مختلف چرخه توسعه هوش مصنوعی به کار گرفته شود. جدول زیر چند کاربرد مهم و ارزش عملی آنها را نشان میدهد.
حوزه کاربرد | نمونه داده مصنوعی | مزیت اصلی |
|---|---|---|
پزشکی | تصاویر پزشکی یا سوابق بیمار شبیهسازیشده | کمک به پژوهش و کاهش نیاز به اشتراکگذاری مستقیم داده حساس |
بانکداری | تراکنشهای عادی و مشکوک شبیهسازیشده | آموزش و آزمایش مدلهای تشخیص تقلب |
خودروهای خودران | تصاویر جاده، عابر و شرایط جوی مختلف | آزمایش سناریوهای نادر و خطرناک |
رباتیک | داده حرکت، تماس و تعامل با اشیا | آموزش مهارتها در محیط شبیهسازی |
تجارت الکترونیک | رفتار خرید و تعامل کاربران شبیهسازیشده | آزمایش سیستمهای پیشنهاددهنده و پیشبینی تقاضا |
امنیت سایبری | ترافیک شبکه و رفتارهای مشکوک مصنوعی | آزمایش سامانههای تشخیص نفوذ |
توسعه نرمافزار | اطلاعات آزمایشی کاربران و سفارشها | تست برنامهها بدون استفاده مستقیم از اطلاعات واقعی مشتریان |
نکته مهم این است که میزان موفقیت در هر حوزه متفاوت است. برای مثال، داده تصویری شبیهسازیشده ممکن است از نظر ظاهری واقعگرایانه باشد، اما نتواند تمام ویژگیهای تصاویر دوربین واقعی را بازتاب دهد. به همین ترتیب، تراکنش مصنوعی ممکن است ساختار عددی مناسبی داشته باشد، ولی رفتار پیچیده مجرمان مالی را بهدرستی بازسازی نکند.
تفاوت داده واقعی و داده مصنوعی چیست؟
داده واقعی از مشاهده، اندازهگیری یا ثبت رویدادهای واقعی به دست میآید؛ در مقابل، داده مصنوعی با استفاده از مدل، الگوریتم یا شبیهسازی تولید میشود. هیچیک از این دو نوع داده در تمام شرایط برتری مطلق ندارند و انتخاب آنها باید بر اساس هدف پروژه انجام شود.
معیار مقایسه | داده واقعی | داده مصنوعی |
|---|---|---|
منشأ | مشاهده و ثبت واقعیت | تولید الگوریتمی یا شبیهسازی |
هزینه آمادهسازی | ممکن است بالا باشد | ممکن است کمتر باشد، اما تولید و اعتبارسنجی هزینه دارد |
برچسبگذاری | گاهی نیازمند کار دستی است | در بسیاری از روشها امکان تولید برچسب خودکار وجود دارد |
حریم خصوصی | ممکن است شامل اطلاعات حساس باشد | خطر افشا میتواند کمتر باشد، اما صفر نیست |
پوشش سناریوهای نادر | تابع فراوانی رخدادهای واقعی است | میتوان سناریوهای خاص را هدفمند تولید کرد |
محدودیت اصلی | کمبود، سوگیری یا دسترسی محدود | خطای شبیهسازی، سوگیری مولد و الگوهای غیرواقعی |
در عمل، یکی از راهبردهای مناسب این است که داده مصنوعی در کنار داده واقعی استفاده شود. این ترکیب میتواند تنوع مجموعهداده را افزایش دهد، بدون آنکه مدل کاملاً به الگوهای تولیدشده توسط یک الگوریتم وابسته شود.
چالشها و محدودیتهای داده مصنوعی
با وجود مزایای متعدد، استفاده از داده مصنوعی بدون کنترل کیفیت میتواند عملکرد مدل را کاهش دهد. اگر داده تولیدشده توزیع ویژگیها، روابط میان متغیرها یا موارد استثنایی دنیای واقعی را بهدرستی منعکس نکند، مدل ممکن است بهجای یادگیری الگوهای معتبر، روابط ساختگی را فرا بگیرد. در چنین شرایطی، نتایج آزمایشگاهی میتوانند امیدوارکننده باشند، اما مدل در محیط واقعی عملکرد ضعیفی نشان دهد.
یکی دیگر از خطرها، بازتولید سوگیریهای موجود در داده اولیه است. اگر مدل مولد از دادههایی آموزش ببیند که نمایندگی مناسبی از گروههای مختلف ندارند، ممکن است همان نابرابریها را در خروجیهای مصنوعی تکرار کند. همچنین، تولید مکرر داده با استفاده از خروجی مدلهای قبلی میتواند در برخی شرایط به کاهش تنوع و تقویت خطاهای انباشته منجر شود؛ مسئلهای که در بحث فروپاشی مدل (Model Collapse) نیز مطرح است.
چگونه کیفیت داده مصنوعی را ارزیابی کنیم؟
برای اطمینان از مفید بودن دادههای مصنوعی، باید آنها را از نظر شباهت آماری، حفظ روابط میان ویژگیها، تنوع نمونهها و خطر افشای اطلاعات بررسی کرد. مهمتر از همه، باید مشخص شود که آیا آموزش با داده مصنوعی واقعاً عملکرد مدل را روی دادههای واقعی و مستقل بهبود میدهد یا خیر. برای این کار، مجموعه آزمون باید تا حد امکان نماینده شرایط واقعی باشد و از نشت اطلاعات میان دادههای آموزش و آزمون جلوگیری شود.
بهترین روش استفاده از داده مصنوعی در یادگیری ماشین
برای استفاده مؤثر از داده مصنوعی، ابتدا باید مشخص شود که مدل با چه مشکلی روبهروست: کمبود داده، نامتوازن بودن کلاسها، محدودیت محرمانگی یا دشواری شبیهسازی شرایط خاص. سپس روش تولید مناسب انتخاب میشود و نمونههای خروجی از نظر کیفیت، تنوع، سازگاری با واقعیت و محرمانگی ارزیابی میشوند. پس از این مرحله، میتوان چند مدل را با ترکیبهای متفاوت داده واقعی و مصنوعی آموزش داد و عملکرد آنها را روی یک مجموعه آزمون مستقل مقایسه کرد. اگر اضافه کردن داده مصنوعی موجب بهبود معیارهای مناسب مسئله شود و این بهبود در شرایط واقعی نیز حفظ شود، استفاده از آن توجیهپذیر خواهد بود. این فرایند باید مستند و قابل تکرار باشد تا در صورت تغییر دادهها یا مدل مولد، کیفیت نتایج دوباره بررسی شود.
نتیجه گیری:
با پیشرفت مدلهای مولد، شبیهسازهای پیشرفته و ابزارهای تولید خودکار داده، انتظار میرود داده مصنوعی نقش پررنگتری در توسعه مدلهای یادگیری ماشین ایفا کند. این فناوری میتواند آموزش مدلها را در حوزههایی که داده واقعی کمیاب، گران یا حساس است، تسهیل کند و امکان بررسی سناریوهایی را فراهم آورد که جمعآوری آنها در دنیای واقعی دشوار است.
بااینحال، آینده این فناوری به حجم داده تولیدشده وابسته نیست، بلکه به کیفیت، تنوع، اعتبار و امنیت آن بستگی دارد. داده مصنوعی زمانی ارزشمند است که توانایی مدل را در حل مسائل واقعی افزایش دهد؛ نه اینکه فقط تعداد نمونههای آموزشی را بیشتر کند. بنابراین، رویکرد واقعبینانه آن است که داده مصنوعی را ابزاری مکمل برای توسعه هوش مصنوعی بدانیم، نه جایگزینی قطعی برای دادههای واقعی.
منبع مقاله:

پاسخ :